pdfOCR 0.9
Описание
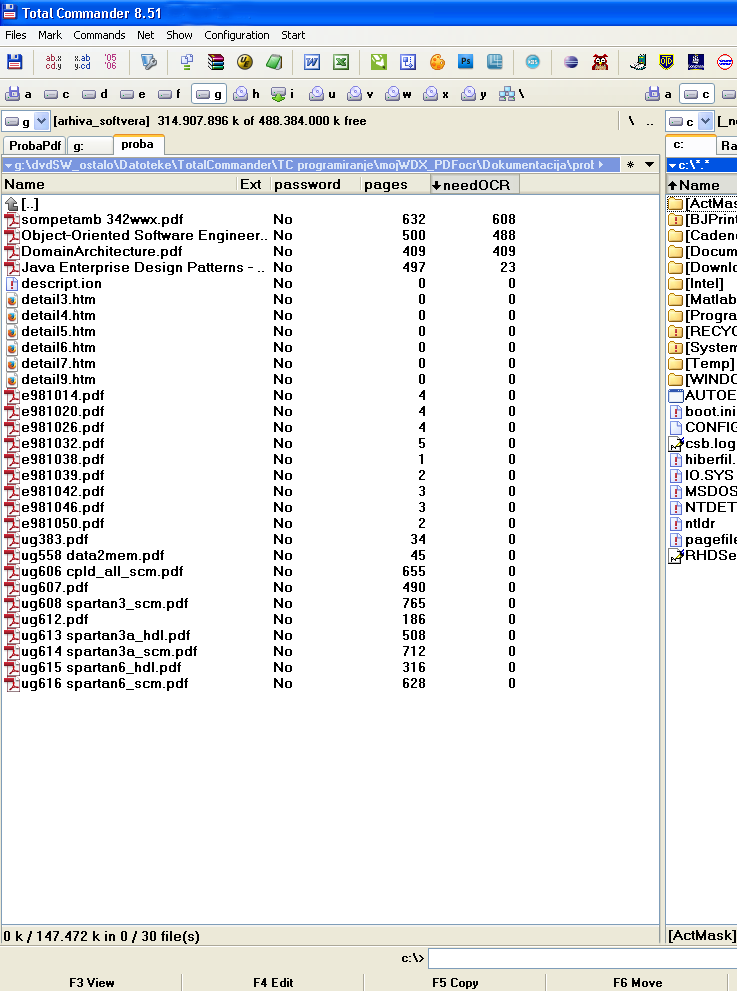
• Назначение:pdfOCR — это wdx-плагин, который определяет, сколько страниц PDF-файла в текущем каталоге нуждается в распознавании символов (OCR), то есть сколько страниц в PDF-файле не содержат в своей структуре текста, доступного для поиска. Это в основном нужно при подготовке PDF-файлов для документации или архивной системы. Как правило, в работе с PDF-файлами их необходимо преобразовать из отсканированной версии в форму с возможностью текстового поиска, прежде чем включать в какую-либо документацию, чтобы обеспечить ручной или автоматический поиск по тексту. Плагин pdfOCR для Total Commander удовлетворяет потребность библиотекаря, показывая количество страниц, которые являются только изображениями и не содержат текста. Количество отсканированных страниц отображается в колонке «needOCR». Сравнивая количество страниц needOCR с общим количеством страниц, можно решить, нужна ли PDF-файлу дополнительная обработка OCR.
• Возможное использование:
- найти pdf-документы, которые нужно обработать OCR впервые
- найти PDF-документы, защищённые паролем и, следовательно, недоступные для обработки OCR
- найти PDF-документы, которые не были должным образом обработаны OCR из-за низкого разрешения или подобных причин
- найти PDF-документы с неправильным форматированием.
• Колонки:
password – YES, если PDF-файл зашифрован целиком или имеет ограниченные права. Обратите внимание: если PDF-файл зашифрован, значения колонок «pages» и «needOCR» не вычисляются и равны 0.
pages – общее количество страниц в PDF-файле.
needOCR – предполагаемое количество страниц в отсканированном виде без текста, доступного для поиска.
• Версия: 0.9beta.
• Ограничения:
- Имена файлов в Unicode – в этой версии не поддерживаются, поэтому используйте только ANSI-имена. Если используются не ANSI-имена, количество страниц будет отрицательным или очень большим числом.
- Скорость – плагин работает относительно медленно, поэтому, когда вы активируете его в панели Total Commander, пожалуйста, наберитесь терпения, пока анализ не завершится и курсор снова не станет доступен.
• Пример использования:
Сначала перейдите в папку, где находятся pdf-файлы. Используйте пункт Configure custom columns в Total Commander (щелчок правой кнопкой мыши по строке Name в панели Total Commander), чтобы определить и отобразить колонки этого плагина: password, pages и needOCR. Дождитесь, пока pdf-файлы будут проанализированы и курсор снова станет доступен. Затем щёлкните по колонке needOCR, чтобы отсортировать страницы needOCR, отметьте нужные файлы, которые требуют обработки OCR, и переключитесь на Brief или другой режим отображения, то есть любой более быстрый плагин, прежде чем работать с отмеченными файлами.
• Установка:
Откройте wdx_pdfOCR_xxx.rar, и вам будет предложено выбрать каталог установки.
• Лицензия: для некоммерческого использования.
• Ошибки:
отрицательное или очень большое количество страниц: обычно это происходит, если pdf имеет неправильное форматирование. В этом случае рекомендуется попробовать следующую процедуру: 1) откройте pdf-файл в любой программе для чтения pdf и пересохраните его; 2) временно переименуйте проблемный pdf-файл при активном плагине, чтобы заставить его перечитать файл.
• Будущие версии:
Если интерес к этому плагину будет большим, я рассмотрю возможность создания гораздо более быстрой версии.
Что нового
ver 0.9 - first public version.